IA para análise semântica de grandes volumes de dados: como fazer um modelo ler mil acórdãos e provar o que leu
O que aprendi construindo o Evidens, um pipeline que usa um LLM para classificar 1.048 decisões judiciais: funil em estágios, documento inteiro no prompt, citação literal validada por código, lotes disjuntos e reprodutibilidade.
 Rafael Faria Ferreira
Uma amiga estava escrevendo o TCC de Direito e tinha uma pergunta que nenhuma busca por palavra-chave responde. Nas apelações em que alguém pede indenização por suposto erro médico e a perícia é contestada, como o tribunal explica por que aceitou, rejeitou ou relativizou o laudo do perito? Para quem vem do software: apelação é o recurso contra uma sentença, acórdão é a decisão de um colegiado de desembargadores sobre esse recurso, e o laudo pericial é o parecer técnico de um médico nomeado pelo juiz. A pergunta não é se o acórdão menciona a perícia. Quase todos mencionam. A pergunta é o que o texto faz com ela.
Para ajudar, construí o Evidens, um pipeline em Python com PostgreSQL que coleta os acórdãos do tribunal, extrai o texto dos PDFs e usa um modelo de linguagem para ler cada um e preencher uma ficha. O modelo é o GPT-6 Luna, com raciocínio alto, chamado pelo Codex CLI. O repositório é privado, mas a lógica de validação é minha e mostro trechos simplificados abaixo. O que segue é o que funcionou para fazer um modelo ler 1.048 documentos e deixar rastro de cada afirmação.
O que tentei primeiro e não funcionou
A primeira versão era um classificador determinístico com expressões regulares. Ele procurava expressões típicas de acolhimento ou rejeição do laudo e atribuía categorias. A segunda etapa foi um piloto: 100 acórdãos sorteados com semente fixa, lidos pela regex e por um LLM anterior como segundo leitor, para medir quanto os dois concordavam.
Concordaram pouco. Na elegibilidade do caso, 45 de 94 (47,9%). No polo passivo, isto é, se o réu era público ou privado, 27 de 94 (28,7%). No tratamento dado à conclusão do perito, 36 de 91 (39,6%). Na cobertura da objeção feita pela parte, 21 de 91 (23,1%). Só a forma da fundamentação passou de 70%: 70 de 91 (76,9%).
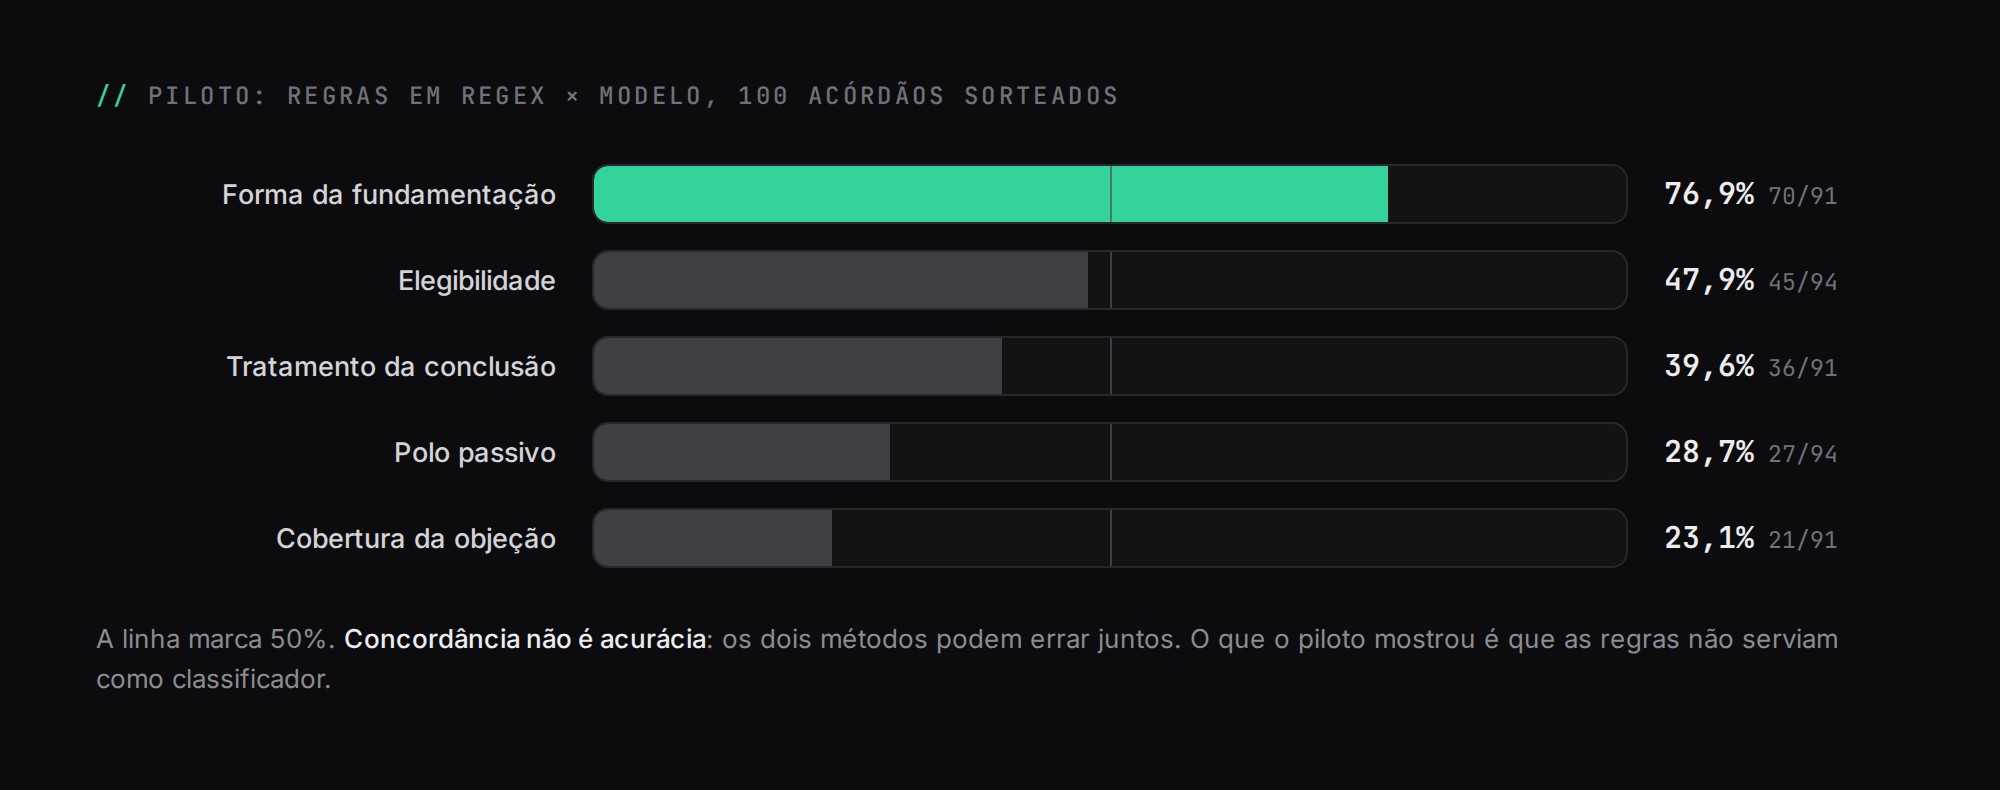
O relatório do piloto tem uma frase que eu repetiria em qualquer projeto parecido: esses percentuais medem concordância, não acurácia. Dois leitores podem concordar e estar ambos errados. Ainda assim, o piloto ensinou o que eu precisava saber. A regex só acertava o que era dito com as palavras previstas, e o mesmo raciocínio jurídico aparece escrito de dezenas de formas. Aposentei as regras como classificador. O pipeline ativo usa só o modelo, e a pergunta passou a ser como confiar no que ele devolve.
1. Funil em estágios: o modelo só onde precisa ler
Ler com um LLM é a etapa mais lenta do pipeline, então ela vem por último. A primeira peneira é a própria busca booleana do tribunal, com três consultas que usam os operadores do sistema de jurisprudência. Elas devolveram 1.499 resultados, que viraram 1.453 documentos distintos depois de deduplicar por identificador oficial e por SHA-256 do arquivo. Desses, 1.412 tinham PDF público, e 1.077 eram acórdãos principais com texto. A coorte analisada ficou em 1.048, e o modelo marcou 518 como inclusão provável.
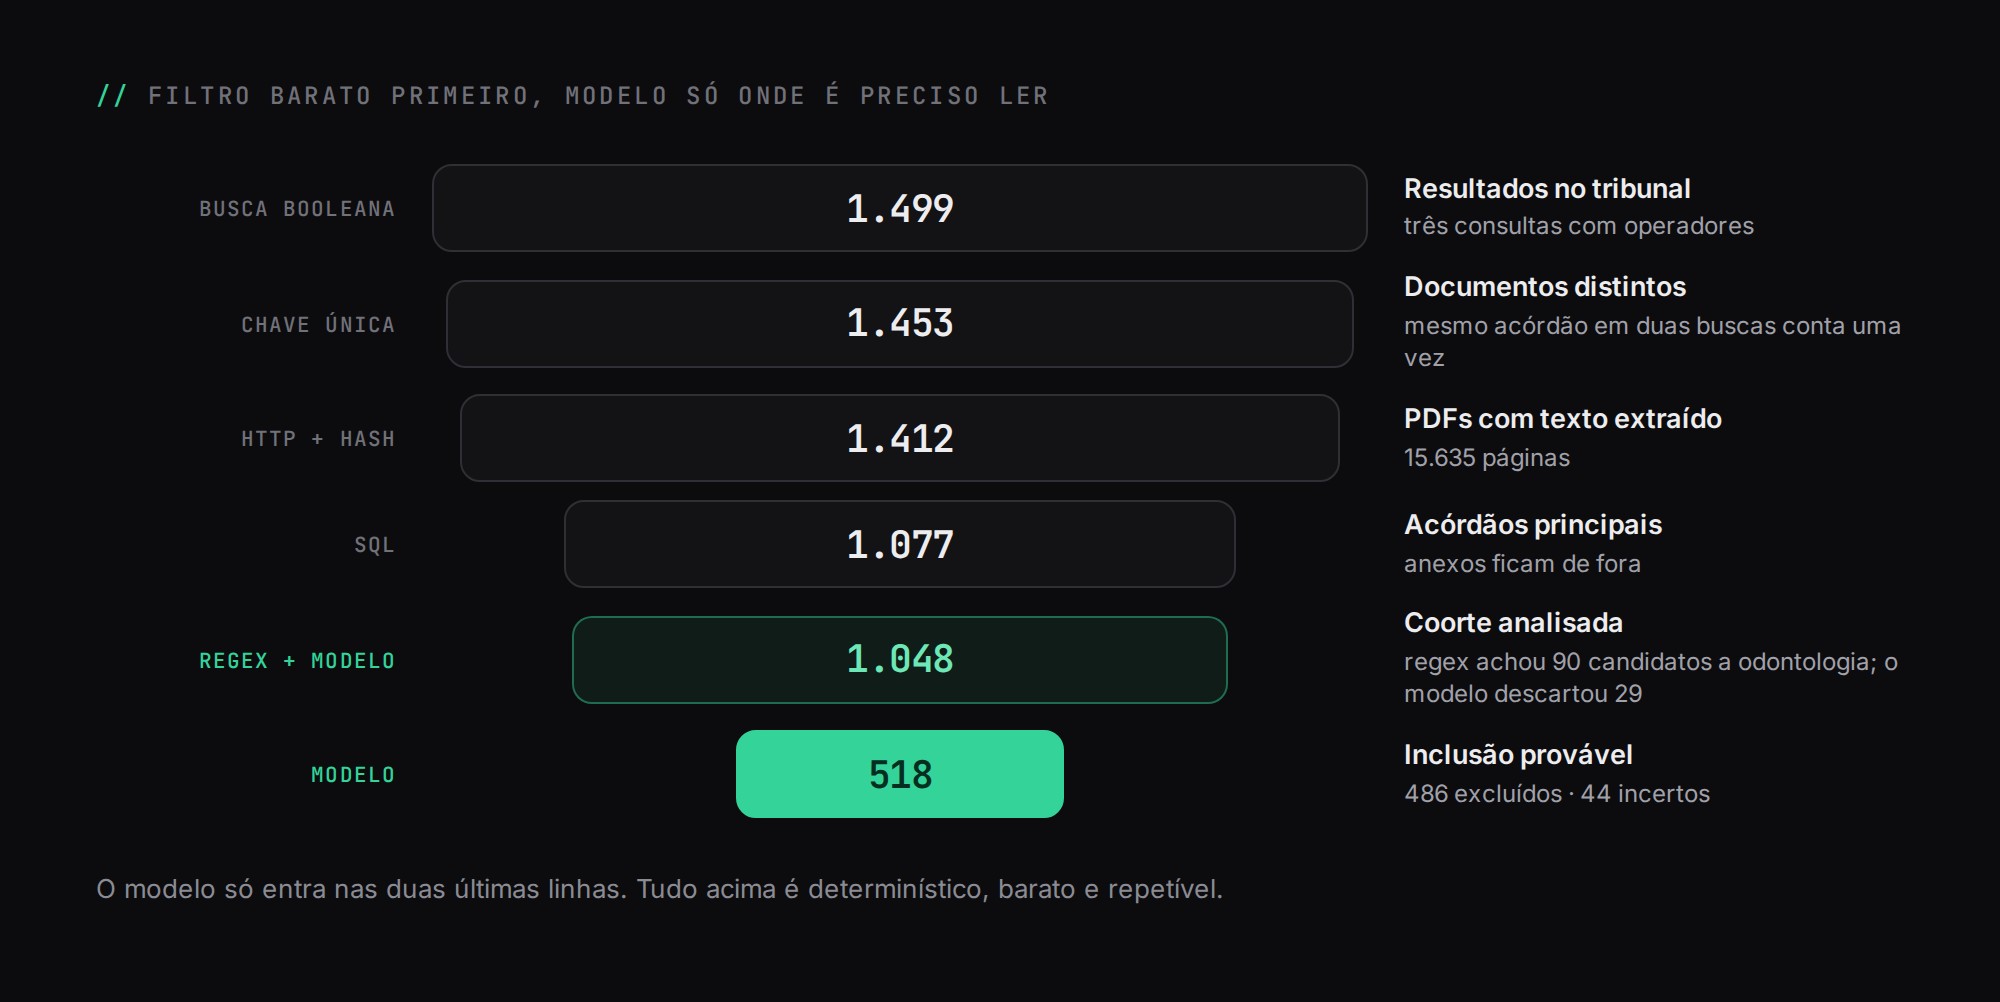
Um exemplo pequeno mostra o padrão. Casos de odontologia precisavam ser separados. Uma regex de alta sensibilidade, feita para pegar tudo e aceitar falso positivo, achou 90 candidatos. O modelo leu só esses 90, com citação obrigatória, e descartou 29 que eram de fato disputas odontológicas, manteve 59 em que a menção era incidental e deixou 2 como incertos. A regex barata reduz o volume; o modelo decide onde é preciso entender o texto.
2. O documento inteiro, organizado por página
Cada chamada recebe um acórdão completo, todas as páginas em ordem, num JSON com metadados e uma lista de páginas numeradas. Não há chunking nem embeddings. No artigo sobre RAG eu fiz o contrário: lá o objetivo era responder a uma pergunta, então bastava recuperar os sete trechos mais relevantes. Aqui o objetivo é classificar todos os documentos, e um argumento que aparece na página 9 e é respondido na página 14 se perde se cada pedaço for lido sozinho.
A numeração das páginas não é enfeite: é ela que permite exigir que cada citação aponte para uma página. E existe um limite explícito, 100 páginas ou 180.000 caracteres. Acima disso o modelo não recebe o documento; o sistema registra uma abstenção com o motivo, em vez de cortar o texto e fingir que leu tudo. O modelo também não recebe classificações anteriores do mesmo documento, para não ser ancorado por elas.
3. Saída fechada, validada duas vezes
A resposta segue um JSON Schema com additionalProperties: false. Os campos são enumerações fechadas: elegibilidade (provável, excluído, incerto), setor do réu (público, privado, misto, incerto), tratamento do laudo (aceito, rejeitado, relativizado, indeterminado), modo da controvérsia, uma lista de até 4 recursos e uma lista de até 20 evidências com id, papel, página, citação e nota.
O schema é passado ao CLI com --output-schema, e a resposta é validada de novo em Python, porque o schema não expressa regras entre campos. O código confere que os ids de evidência são únicos e existem, que cada evidência tem o papel certo, que "inclusão provável" exige controvérsia expressa ou valoração indireta, e que valoração indireta vem com três evidências separadas. Os resumos de topo são derivados dos recursos, então o modelo não consegue dizer uma coisa no recurso e outra no resumo.
4. Toda afirmação precisa de uma citação literal
Esta é a parte que mais mudou minha confiança no resultado. Cada evidência traz uma citação e o número da página, e o código verifica que aquele texto existe naquela página. Ficha sem abstenção e sem nenhuma citação é reprovada. A verificação tem três passos, do mais estrito ao mais tolerante, e todos toleram apenas diferença de espaço em branco:
def localizar_citacao(pagina: str, citacao: str) -> tuple[int, int, str]:
    inicio = pagina.find(citacao)
    if inicio >= 0:
        return inicio, inicio + len(citacao), "exact"

    # espaços e quebras de linha colapsados, com offsets da fonte
    achou = buscar_com_espacos_colapsados(pagina, citacao)
    if achou:
        return (*achou, "normalized_whitespace")

    # sem nenhum espaço: PDF que quebra linha no meio de um identificador
    achou = buscar_sem_espacos(pagina, citacao)
    if achou:
        return (*achou, "whitespace_insensitive")

    raise CitationValidationError("citação não é trecho literal da página")
Quando casa, o texto guardado passa a ser o recorte exato da fonte, com os offsets e o método usado. Na campanha final foram 7.426 citações: 1.050 bateram por correspondência exata, 6.296 depois de normalizar espaços e quebras de linha, e 80 só ignorando todos os espaços, quase sempre um número que o PDF partiu em duas linhas.
Não usei correspondência aproximada de propósito. Não ignoro acento, maiúscula nem reticências. Uma citação "quase igual" é justamente o lugar onde o modelo parafraseia, e paráfrase de decisão judicial é onde o sentido muda. Se a regra aceitar 95% de semelhança, ela aceita o "não" que sumiu.
5. Uma nova tentativa, que corrige a evidência mas não a resposta
Se a citação falha, o modelo recebe de volta o erro e o próprio JSON anterior, com a instrução de corrigir só as evidências. O código compara as duas respostas campo a campo: se na correção o modelo mudar a classificação ou a justificativa, o resultado é rejeitado como retry_changed_classification. Sem essa trava, a nova tentativa vira uma segunda opinião escolhida pelo validador, e não uma correção de referência. Falhas de estrutura, como uma regra entre campos violada, também ganham uma nova tentativa que aponta a inconsistência. Falhou de novo, o registro fica como falha com o tipo do erro, e as duas respostas ficam guardadas.
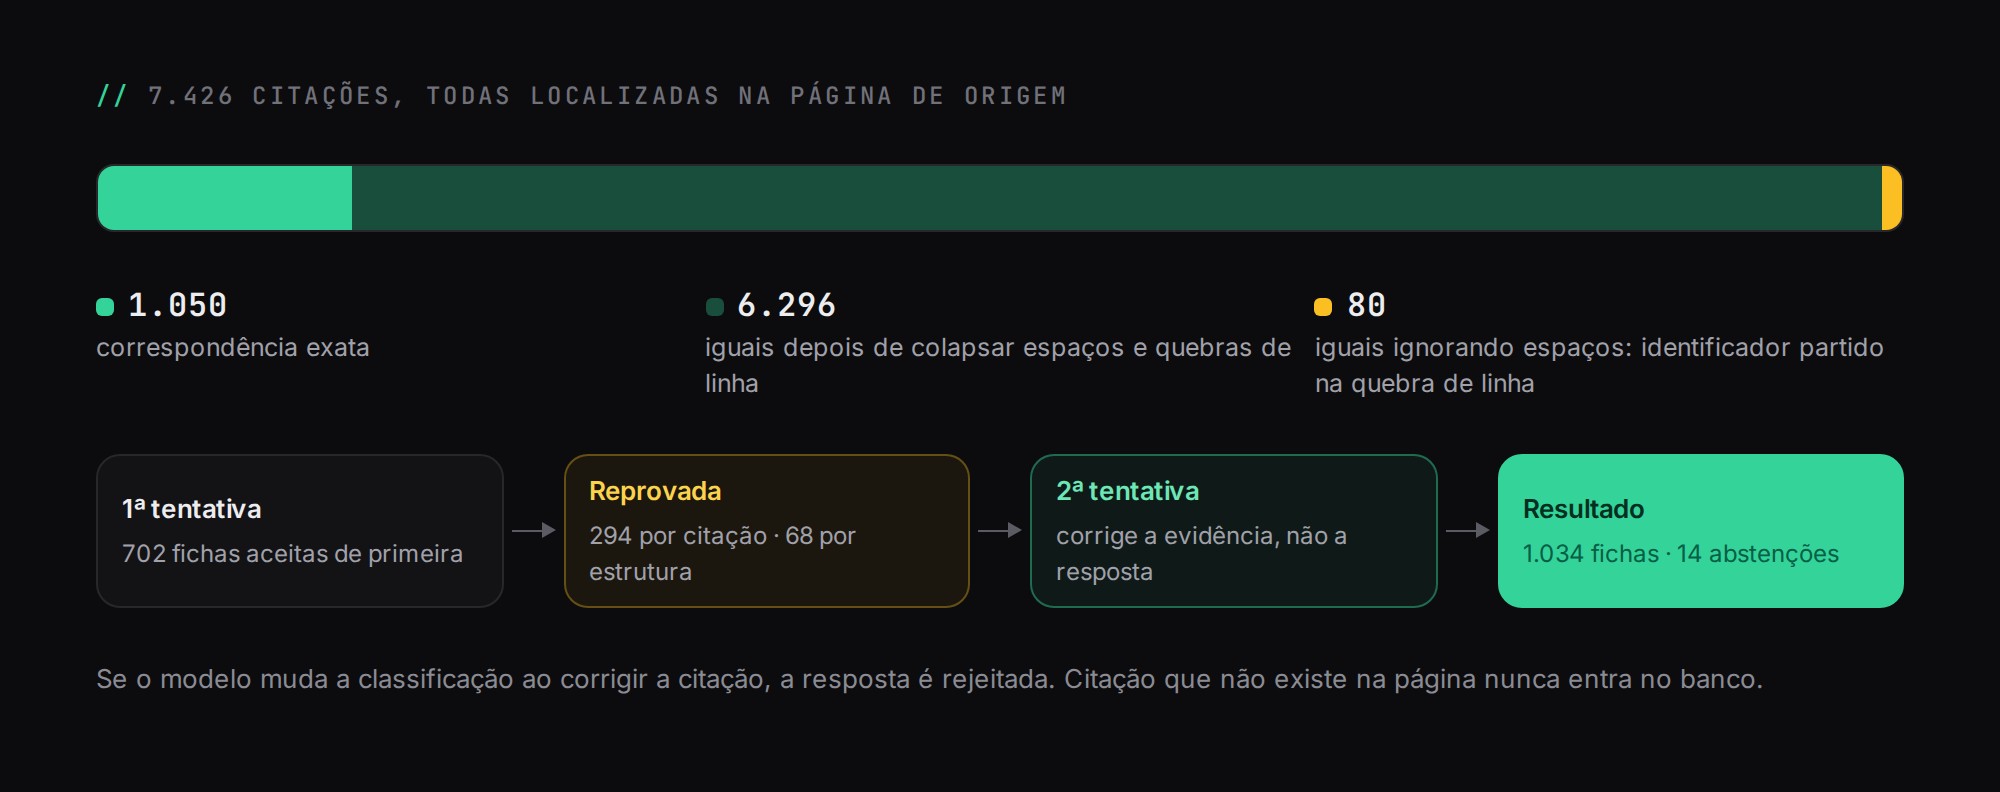
Na prática, 702 fichas saíram na primeira tentativa e 330 precisaram da segunda. Houve 294 tentativas reprovadas por citação inválida e 68 por estrutura inválida, todas refeitas. Ao final, a coorte de 1.048 terminou com 1.034 fichas concluídas, 14 abstenções e nenhuma falha pendente.
6. Abster e dizer "incerto" são respostas válidas
O roteiro dado ao modelo diz, em inglês no código, para não inferir que um argumento não relatado esteve ausente e, se o texto não sustentar uma avaliação confiável, abster e explicar o motivo em vez de preencher a lacuna com um palpite. As 14 abstenções e os 44 casos de elegibilidade incerta não são defeito do pipeline. São o pipeline dizendo onde a leitura não se sustenta, o que é bem mais útil do que 58 respostas inventadas com a mesma confiança das outras.
O mesmo roteiro trata o texto das páginas como dado não confiável: o modelo não deve seguir instruções que apareçam dentro de uma página. É uma defesa contra prompt injection, e ela não depende só do prompt. O CLI roda com sandbox somente leitura, num diretório de trabalho vazio, sem estado entre documentos e com timeout de 180 segundos. Se um PDF contiver uma instrução maliciosa, o pior resultado possível é uma ficha errada, que ainda precisa passar pela validação de citações.
7. Escalar com lotes disjuntos, não com concorrência esperta
A primeira campanha, com uma versão antiga do roteiro, começou em sequência, a cerca de 33 segundos por documento. Para a campanha final, congelei a coorte e dividi os documentos em 18 lotes com um particionamento guloso e determinístico: o maior documento vai para o lote menos carregado, até acabar. Cada lote vira um manifesto JSON, criado uma única vez e com hash próprio. Uma tabela de atribuição com chave (campanha, acórdão) garante que nenhum documento pertença a dois lotes.
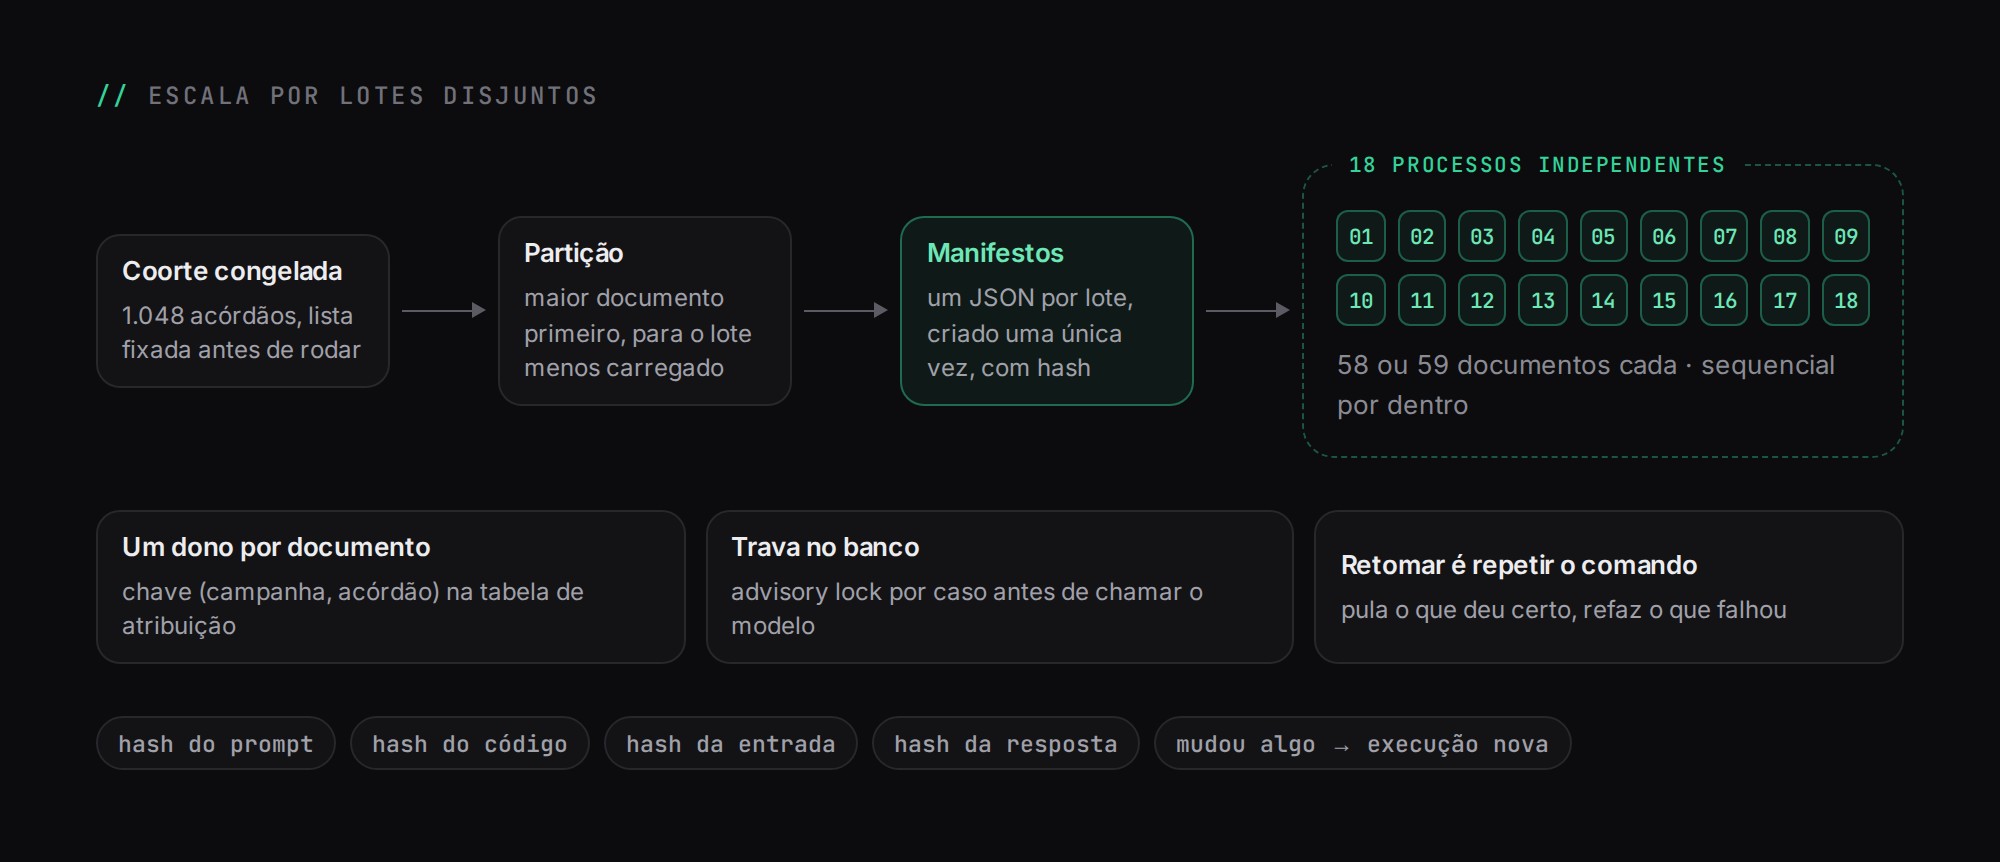
Os workers são processos independentes, sequenciais por dentro. Antes de chamar o modelo, cada um pega um advisory lock do PostgreSQL para o caso. Se um processo cai, retomar pula o que deu certo e refaz só as falhas. Foram 18 execuções de 58 ou 59 documentos, e pelos registros a campanha levou cerca de 2 h 36 min entre o início e o fim. Não há fila distribuída nem orquestrador: a garantia vem da partição, e o lock é só a segunda camada.
8. Reprodutibilidade: tudo tem hash
Cada ficha guarda o hash do prompt (versão, roteiro e schema), o hash do próprio arquivo-fonte do avaliador, da entrada textual, do PDF, do pedido e da resposta, além da resposta bruta. Retomar uma execução é recusado se o modelo, o prompt ou o código mudaram. E mudar o roteiro de avaliação nunca reescreve resultados: cria uma execução nova, e a anterior continua no banco. Foi assim que a rubrica evoluiu de uma ficha geral por acórdão para evidência por recurso sem perder o histórico.
O que a IA não entrega
O projeto declara seus limites, e eles valem para qualquer uso parecido. O dado é o texto do acórdão: o pipeline não mede com que frequência o tribunal se comporta de um jeito, não dá nota à decisão e não deduz se o julgador leu o laudo. Silêncio do acórdão não prova que o argumento não existiu. O corpus é o que três consultas recuperaram de um sistema de busca, não o universo dos processos.
O mais importante: ainda não há validação humana concluída. A ferramenta existe. Ela sorteia uma amostra cega e estratificada com semente fixa, gera um CSV sem os rótulos do modelo e abre uma interface local com o PDF e o texto lado a lado. Os rótulos do modelo ficam ocultos até que todos os casos da amostra tenham revisão humana, e só então a concordância por campo aparece. Mas essa revisão ainda não foi feita, então a classificação do modelo é preliminar. A citação literal prova que o trecho existe, não que a interpretação está certa. Também não registrei custo nem consumo de tokens, então não tenho esse número para dar.
Checklist para o seu corpus
- Escreva a pergunta de forma que só a leitura responda, e confirme isso com um piloto contra uma regra simples.
- Monte um funil: filtros baratos e sensíveis antes, o modelo só no que sobra.
- Se a tarefa é classificar todo documento, mande o documento inteiro, numerado, com limite explícito e abstenção acima dele.
- Feche a saída num schema e valide em código as regras entre campos.
- Exija citação literal com página e verifique mecanicamente, sem correspondência aproximada.
- Permita uma nova tentativa que corrija a evidência e rejeite a que muda a resposta.
- Trate abstenção e "incerto" como saídas de primeira classe, e o texto de entrada como dado não confiável.
- Escale com lotes disjuntos e retomáveis, guarde hash de tudo e trate roteiro novo como execução nova.
- Planeje a validação humana cega desde o início, e não chame o resultado de definitivo antes dela.
O painel, a metodologia e os números completos estão na página do projeto Evidens.