Filas no Markmedi: como o Horizon separa o lembrete do paciente da campanha de e-mail
Supervisores com capacidade fixa, invariantes de timeout testadas, rate limit global para o SES e um ledger de idempotência: como organizei as filas do Markmedi com Laravel Horizon.
 Rafael Faria Ferreira
Num sistema de clínica, a fila de jobs carrega coisas com urgências muito diferentes. O lembrete da consulta de amanhã precisa sair no horário. A transcrição de uma consulta pode levar minutos de processamento de IA. Uma campanha de e-mail para quatro mil contatos pode ocupar um worker por meia hora. E o vídeo de evolução de fotos de um paciente usa ffmpeg e memória. Se tudo isso divide a mesma fila, a campanha de marketing atrasa o lembrete, e o paciente não aparece.
O Markmedi roda em Redis com Laravel Horizon, e a organização das filas foi uma das partes em que mais apanhei até chegar ao desenho atual.
Supervisores com capacidade fixa
Em vez de deixar o Horizon balancear processos automaticamente, cada supervisor tem número fixo de processos (mínimo igual ao máximo) e consome um conjunto pequeno de filas. Isso troca um pouco de eficiência por previsibilidade: eu sei exatamente quantos workers existem para cada tipo de trabalho e quanta memória o contêiner vai usar.
Supervisor | Filas (em ordem de prioridade) | Processos | Para quê |
|---|---|---|---|
clinic | critical, default | 2 | Gatilhos de lembrete e confirmação, webhooks de provedores, notificações transacionais e o trabalho comum da clínica |
ai | ai | 2 | Transcrição, resumos, anamnese assistida, análises |
emails | emails | 1 | Disparo de campanhas e envio de e-mail marketing |
media | media | 1 | Gravações, vídeos de evolução, exportação de prontuário |
O ponto importante é o que fica dentro do supervisor clinic. A fila critical recebe os jobs que disparam lembretes e pedidos de confirmação e o processamento dos webhooks de WhatsApp, SMS e e-mail. Como o supervisor consome critical antes de default, esses jobs passam na frente. As notificações transacionais em si (o WhatsApp do lembrete, o e-mail de confirmação) saem na default do mesmo supervisor. Não existe uma fila exclusiva de WhatsApp. O que existe é o isolamento do que é pesado e não urgente: IA, mídia e marketing nunca consomem a capacidade da clínica.
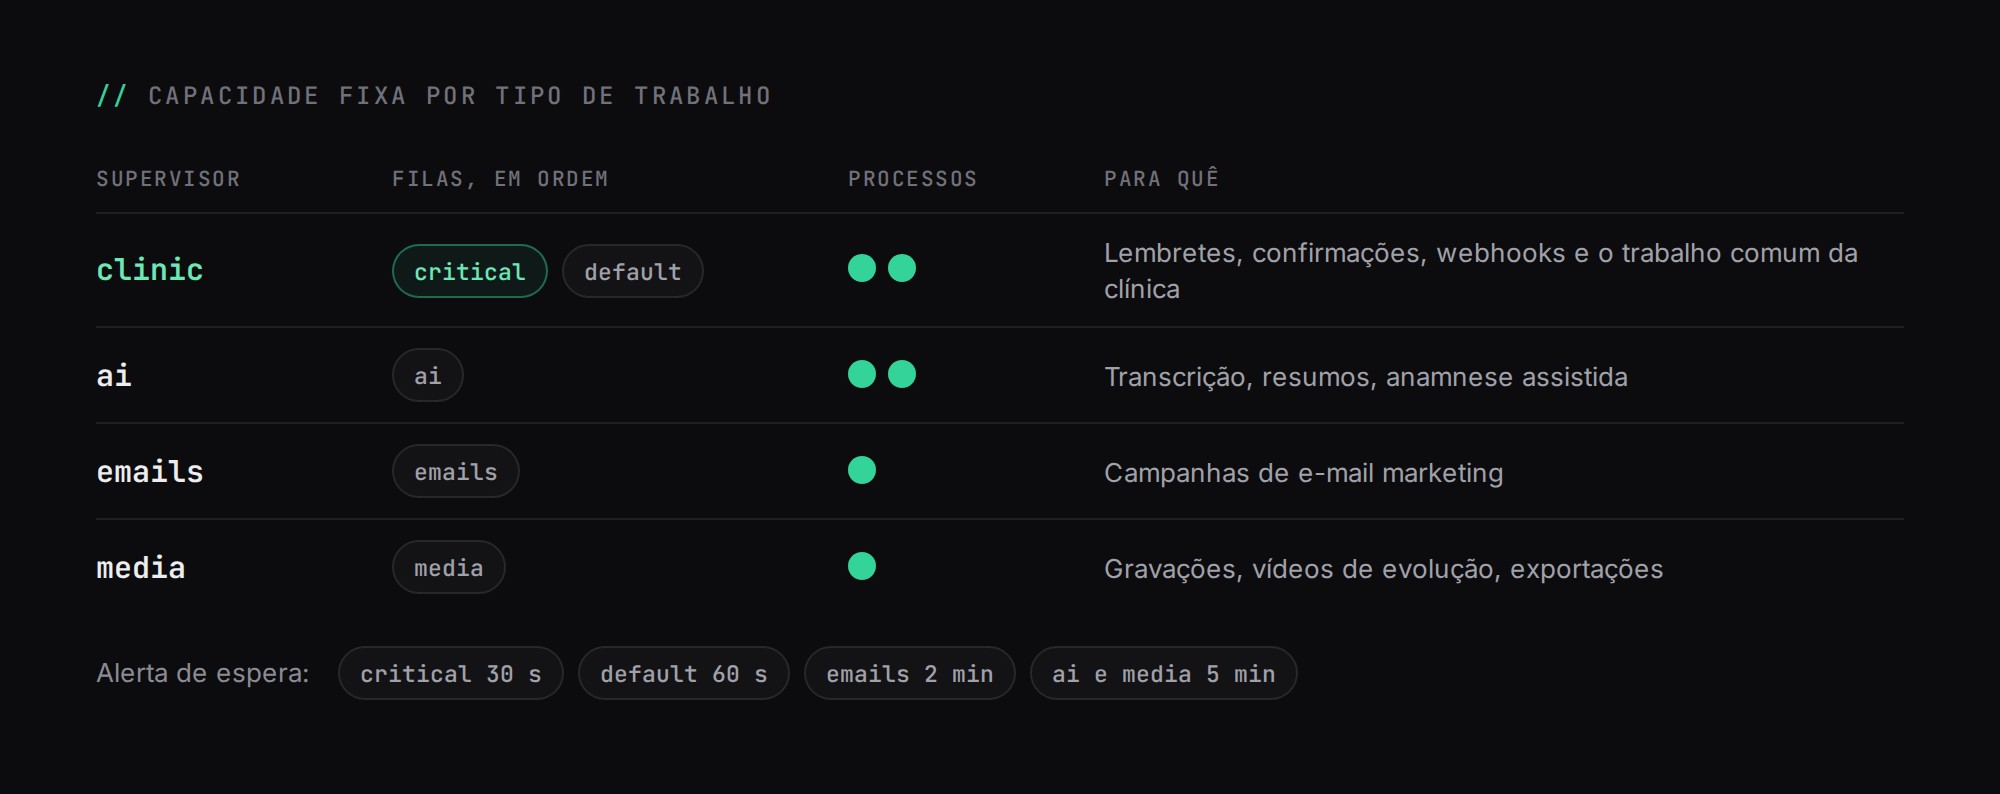
Também configurei limites de espera por fila, que disparam alerta quando um job fica parado tempo demais: 30 segundos para critical, 60 para default, 2 minutos para e-mails e 5 minutos para IA e mídia.
Uma invariante de timeout que virou teste
Um bug clássico de fila em Redis é o job ser entregue duas vezes. Acontece quando o job demora mais que o retry_after da conexão: o Redis acha que o worker morreu e entrega o job a outro worker, enquanto o primeiro ainda está trabalhando. Para isso não depender de alguém lembrar, existe um teste de configuração com uma tabela de todos os jobs relevantes. Ele confere a fila de cada um e a cadeia de tempos:
timeout do job < timeout do supervisor < retry_after da conexão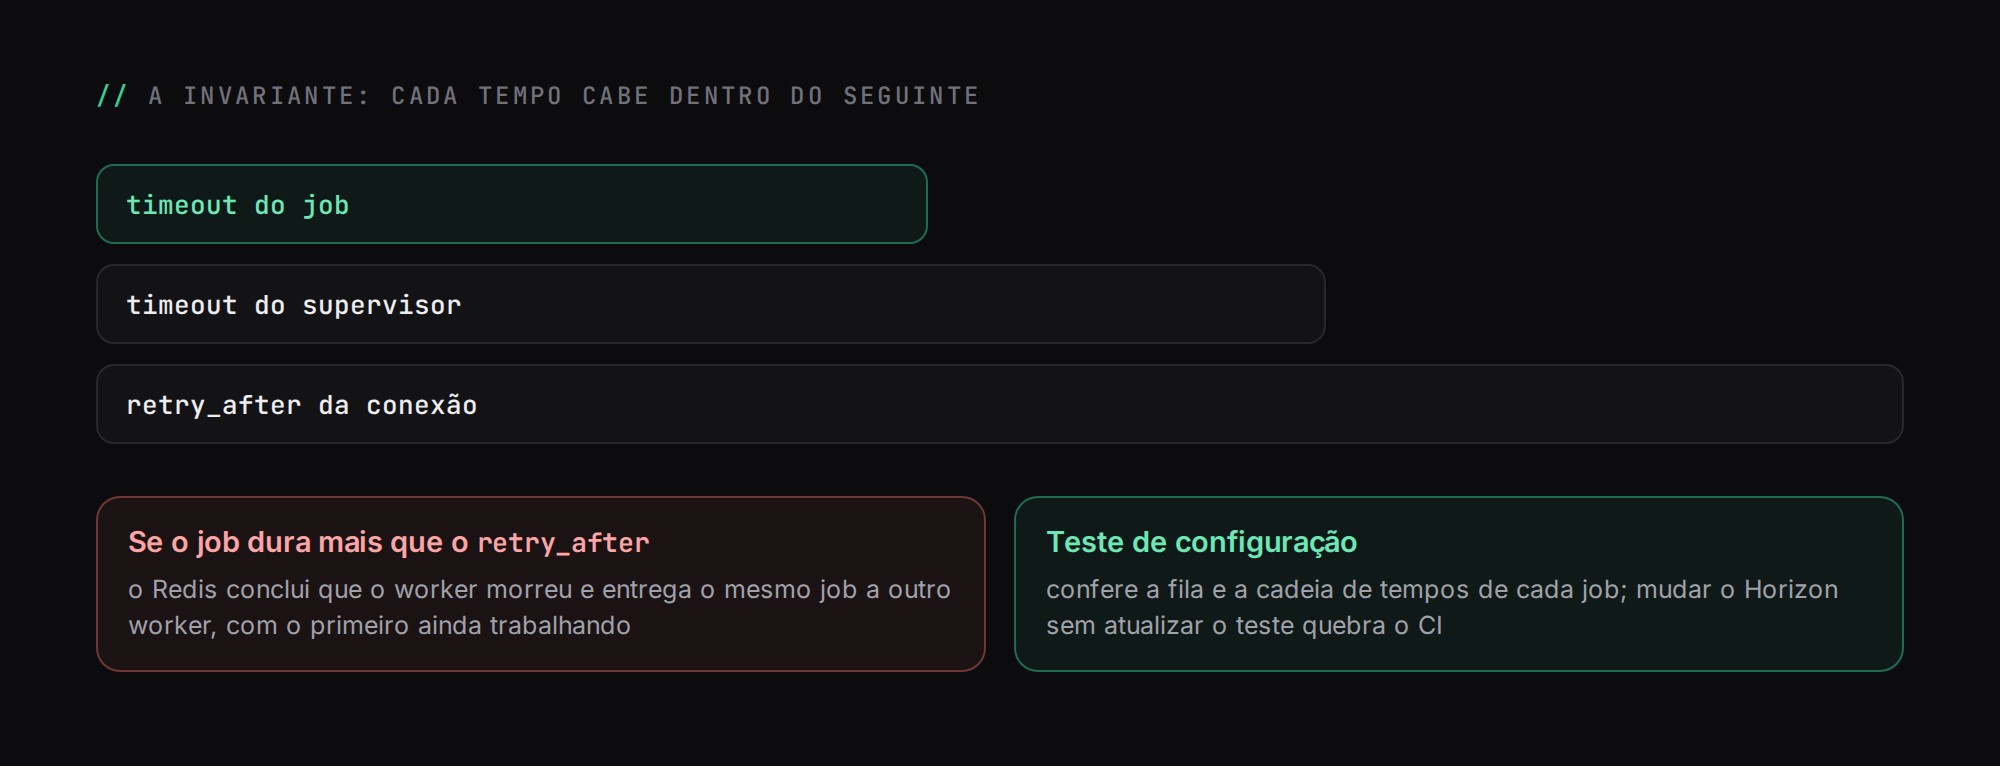
O mesmo arquivo confere o total de workers e garante que mídia e campanhas não consomem capacidade da clínica. Mudar a configuração do Horizon sem atualizar o teste quebra o CI, e é exatamente isso que eu quero.
Rate limit global para o Amazon SES
Cada destinatário de uma campanha é um job, e esses jobs passam por um rate limiter chamado ses-send. Ele é global, e não por clínica, porque o limite de envio do SES é da conta inteira, não de cada cliente. Um limite por clínica permitiria que dez clínicas disparando ao mesmo tempo estourassem a cota da conta e começassem a tomar erro de throttling.
O job de envio tem várias proteções em volta disso: número de exceções limitado, backoff progressivo (30 s, 2 min, 5 min) e um prazo máximo de 12 horas para tentar. Quando a campanha é pausada, o job não gasta uma vaga do rate limiter só para descobrir que está pausado: ele confere o estado, volta para a fila mais tarde e estende o próprio prazo. A arquitetura completa do módulo de e-mail está em e-mail marketing com BYOD e Amazon SES.
Job que sabe que ficou velho
Um lembrete é agendado para 24 horas antes da consulta. Se a recepção remarca a consulta depois disso, o job antigo continua na fila. A solução foi dar à consulta um reminder_version que muda a cada remarcação. O job carrega a versão que viu e, ao rodar, descarta a si mesmo se ela mudou. Ele também desiste se a consulta já foi concluída ou cancelada, se o paciente não tem como ser contatado ou se o plano da clínica não inclui aquele recurso.
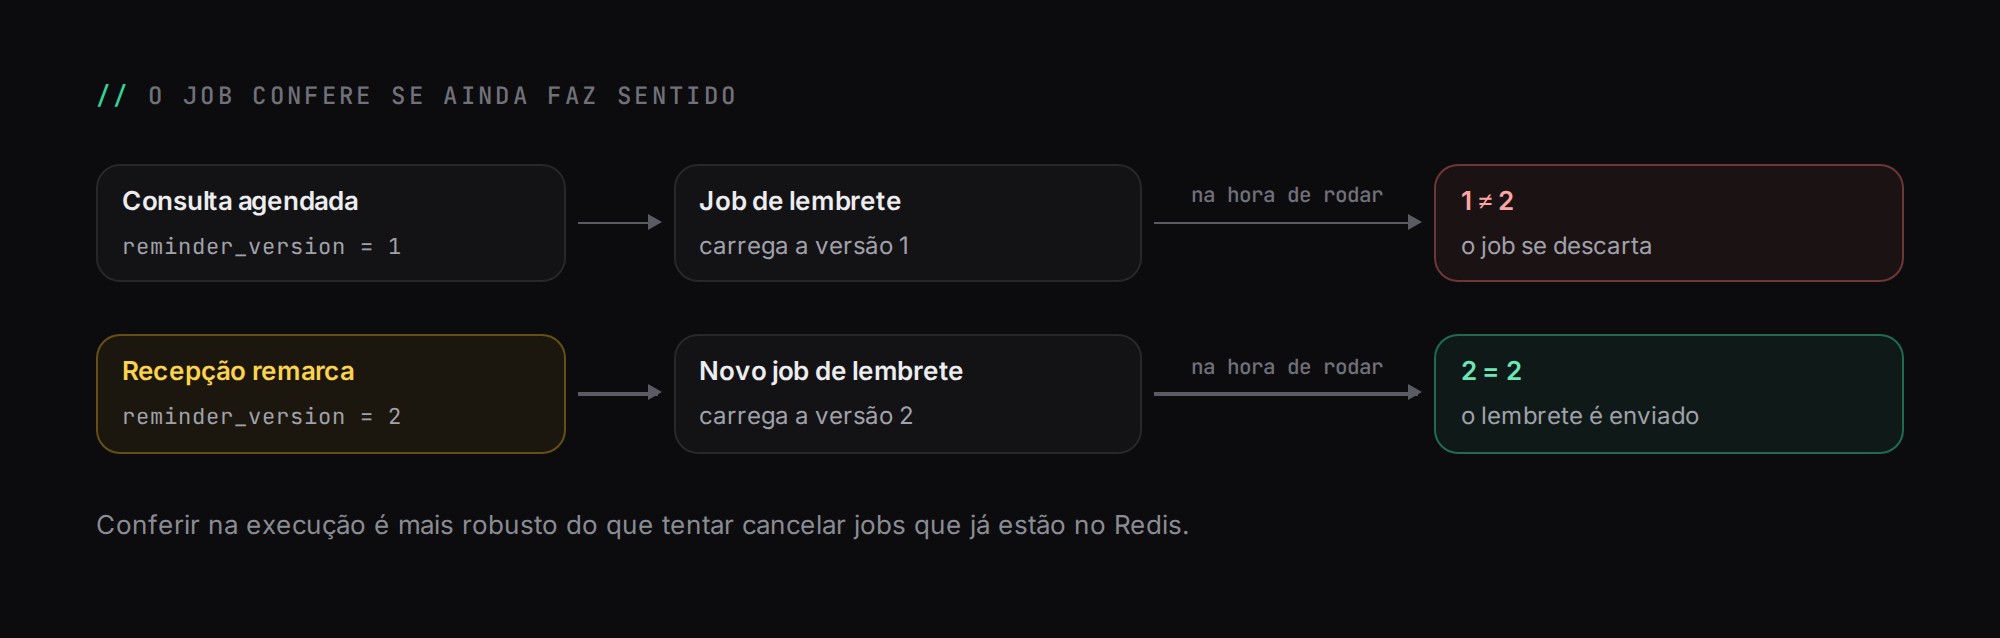
Esse padrão de "conferir se ainda faz sentido" na hora de executar é mais robusto do que tentar cancelar jobs na fila, que é algo que o Redis não faz bem.
Um ledger para nunca enviar duas vezes
Mesmo com tudo isso, um job pode rodar duas vezes: um worker morre depois de enviar e antes de confirmar, ou um deploy reinicia o processo no pior momento. Para mensagens ao paciente, enviar duas vezes é um problema real. Toda mensagem de saída passa por uma tabela de ledger com uma chave de idempotência única, derivada do que a mensagem representa, como "receita pronta da prescrição X" ou "passo N da sequência Y".
try {
    $message = OutboundMessage::create(['idempotency_key' => $key, ...]);
} catch (UniqueConstraintViolationException) {
    return DispatchResult::alreadySent(); // perdeu a corrida: outro worker já enviou
}
O canal confere antes se a chave existe e, se perder a corrida no insert, trata a violação de unicidade como "já enviado". O fallback de SMS segue a mesma ideia: depois de um envio por WhatsApp, um job de SMS é agendado com alguns minutos de atraso e reaproveita a chave de idempotência do envio original, para continuar amarrado à mesma mensagem lógica.
Nada sai antes do commit
Outro cuidado é a ordem entre banco e fila. Notificações e eventos de domínio são despachados só depois do commit da transação. Sem isso, um job pode começar antes de a transação terminar, procurar a consulta que acabou de ser criada e não encontrar, ou pior, enviar a confirmação de um agendamento que sofreu rollback.
Testando a fila de verdade
Nos testes comuns a fila roda em modo síncrono, o que é ótimo para testar regra de negócio e inútil para testar confiabilidade. Por isso o CI tem um job separado que sobe Redis e Supervisor de verdade e roda testes de ciclo de vida da fila:
- um job só é reentregue depois da janela de queda do worker;
- um SIGTERM durante o deploy encerra o worker sem perder o backlog;
- a recuperação depois de uma queda não duplica o efeito do job;
- jobs de um mesmo relatório rodam serializados.
Esse tipo de teste cobre o que nenhum teste unitário alcança. Um exemplo é a configuração do Supervisor: o tempo de espera no desligamento precisa ser maior que o job mais longo, senão um deploy mata o worker no meio do trabalho.
Status em tempo real
Alguns jobs longos reportam progresso para a interface. A análise de posicionamento da clínica, por exemplo, emite eventos de progresso por WebSocket com o Reverb, e a tela tem um polling de reserva caso a conexão caia. Os detalhes estão em tempo real com Laravel Reverb.
Resumo
Separei o trabalho por urgência e custo, não por tecnologia. Fixei a capacidade de cada supervisor para que o servidor tenha comportamento previsível. As regras que mais causariam incidente (tempos, isolamento, idempotência) viraram testes. O Horizon fica com o que faz bem, visibilidade e supervisão, e a correção de cada envio fica no código da aplicação.
Este texto faz parte da série sobre o Markmedi. Para ver o que acontece antes do job entrar na fila, leia arquitetura, DDD e eventos.