Infraestrutura enxuta e resistente a falhas: CI/CD, backup e recuperação
Um servidor, um contêiner e um plano de continuidade de cerca de US$ 7/mês: como o Markmedi sai do merge para a produção e como volta de uma falha com RPO de 15 minutos.
 Rafael Faria Ferreira
Um SaaS de saúde operado por uma pessoa só tem duas formas de errar a infraestrutura. A primeira é montar um cluster Kubernetes com três ambientes e gastar mais tempo cuidando da plataforma do que do produto. A segunda é colocar tudo num servidor, fazer um backup diário no mesmo provedor e torcer. Passei um tempo na segunda e decidi que o problema não era ter um servidor só. O problema era não saber o que acontecia quando ele sumisse.
Este artigo descreve como o Markmedi roda hoje: uma infraestrutura deliberadamente pequena, com um plano de continuidade que custa pouco e foi testado de verdade.
A pilha
A aplicação roda num único servidor na Hetzner, atrás do proxy da Cloudflare, gerenciado pelo Coolify. Tudo o que é aplicação está numa imagem Docker multi-stage: um estágio compila as extensões do PHP, outro instala as dependências do Composer sem pacotes de desenvolvimento, outro compila o front-end com Node, e o estágio final junta PHP-FPM, Nginx e o ffmpeg (usado para gerar o vídeo de evolução das fotos clínicas). Dentro do contêiner, o Supervisor cuida de cinco processos: PHP-FPM, Nginx, Reverb, Horizon e o scheduler.
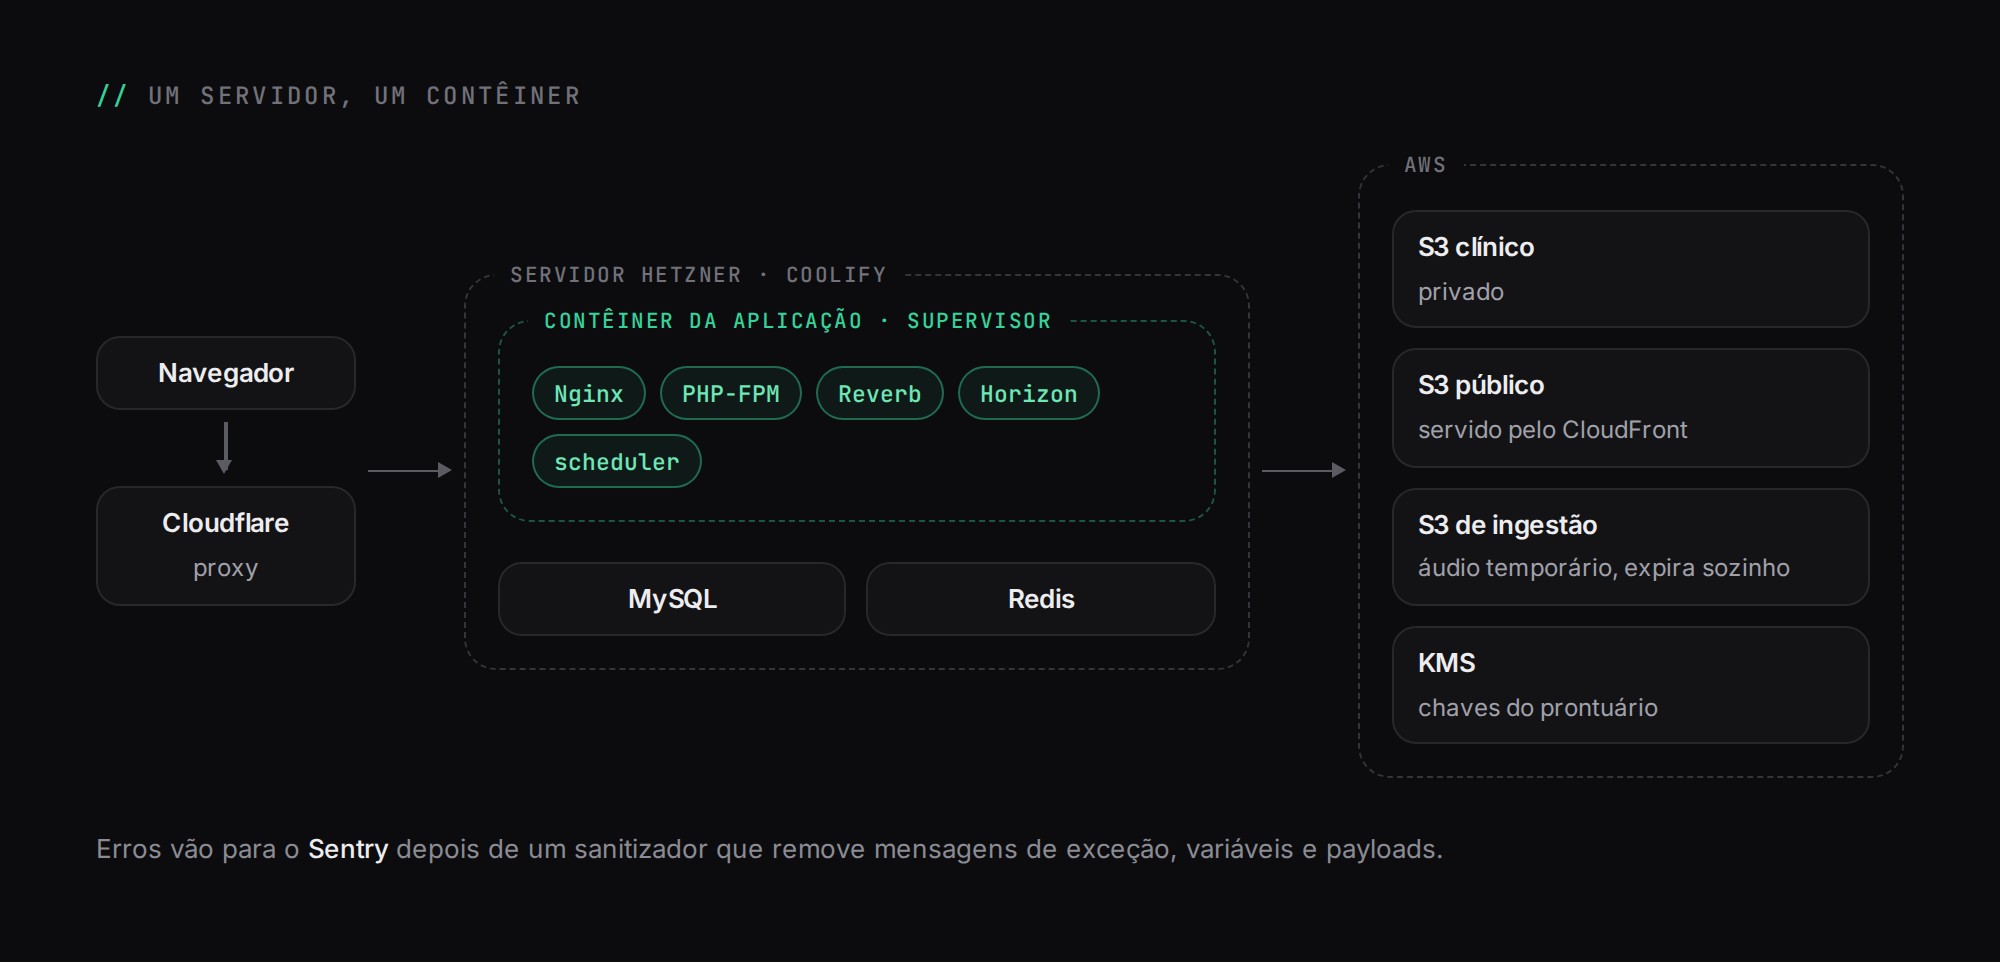
MySQL e Redis rodam como recursos do Coolify, fora da imagem. Os arquivos ficam na AWS, em três buckets S3 com papéis distintos: o clínico (privado), o público (servido pelo CloudFront) e um de ingestão temporária para áudio de teleconsulta, que expira sozinho. Erros vão para o Sentry, com um sanitizador que reconstrói cada evento e remove mensagens de exceção, variáveis de stack e payloads antes do envio, porque mensagem de exceção é um lugar clássico para dado de paciente escapar.
Escolhi um contêiner com vários processos em vez de um contêiner por processo porque, com uma réplica só, a separação não compra isolamento real e multiplica o trabalho de deploy. O lado ruim é conhecido: se o Horizon cai, o site continua no ar e ninguém percebe. Isso é resolvido pela vigilância, mais abaixo.
Do pull request à produção
A branch main é protegida e só aceita merge com o CI verde. O CI no GitHub Actions tem vários jobs independentes, cada um respondendo a uma pergunta diferente:
Job | O que garante |
|---|---|
lint | Pint, Prettier e ESLint |
ci | Testes de unidade e de feature em PHP 8.4 e 8.5, em paralelo, e testes de front-end |
browser | Testes de navegador com Pest e Playwright, divididos em quatro shards |
schema | Todas as migrations num MySQL 8 real, mais checagens que o SQLite não faz |
queue-state e cache-state | Comportamento das filas com Redis e Supervisor reais: crash, redelivery e desligamento gracioso |
Os detalhes da suíte estão em TDD e CI. Depois do merge, o Coolify recebe o webhook, constrói a imagem e só troca o tráfego quando o healthcheck do novo contêiner responde. Se não responder, a versão anterior continua no ar.
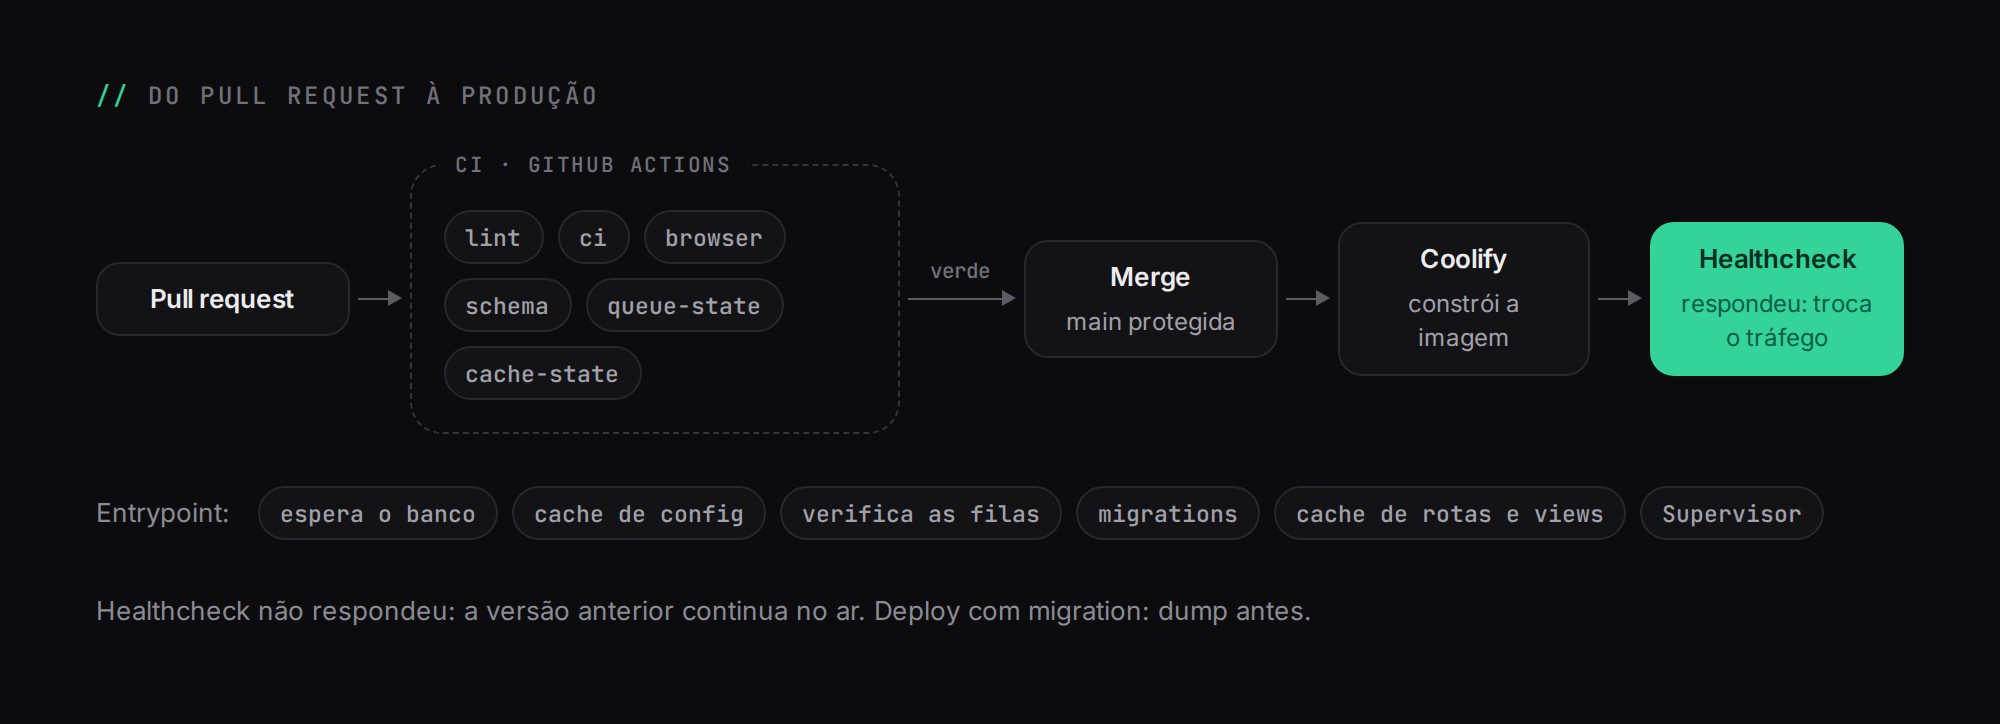
O entrypoint do contêiner é curto e ordenado: espera o banco, faz cache da configuração, roda uma verificação do runtime das filas (para não subir com Horizon e configuração de fila incompatíveis), aplica as migrations e só então faz o cache de rotas, eventos e views e entrega o controle ao Supervisor.
A regra para deploys com migration é tirar um dump antes. Ele é o ponto de retorno. Voltar o código é um clique no Coolify (selecionar a imagem anterior); voltar dados exige o procedimento de recuperação no tempo, descrito abaixo. E todo rollback é seguido de um PR de reversão na main, senão o próximo merge traz o defeito de volta.
O plano de continuidade
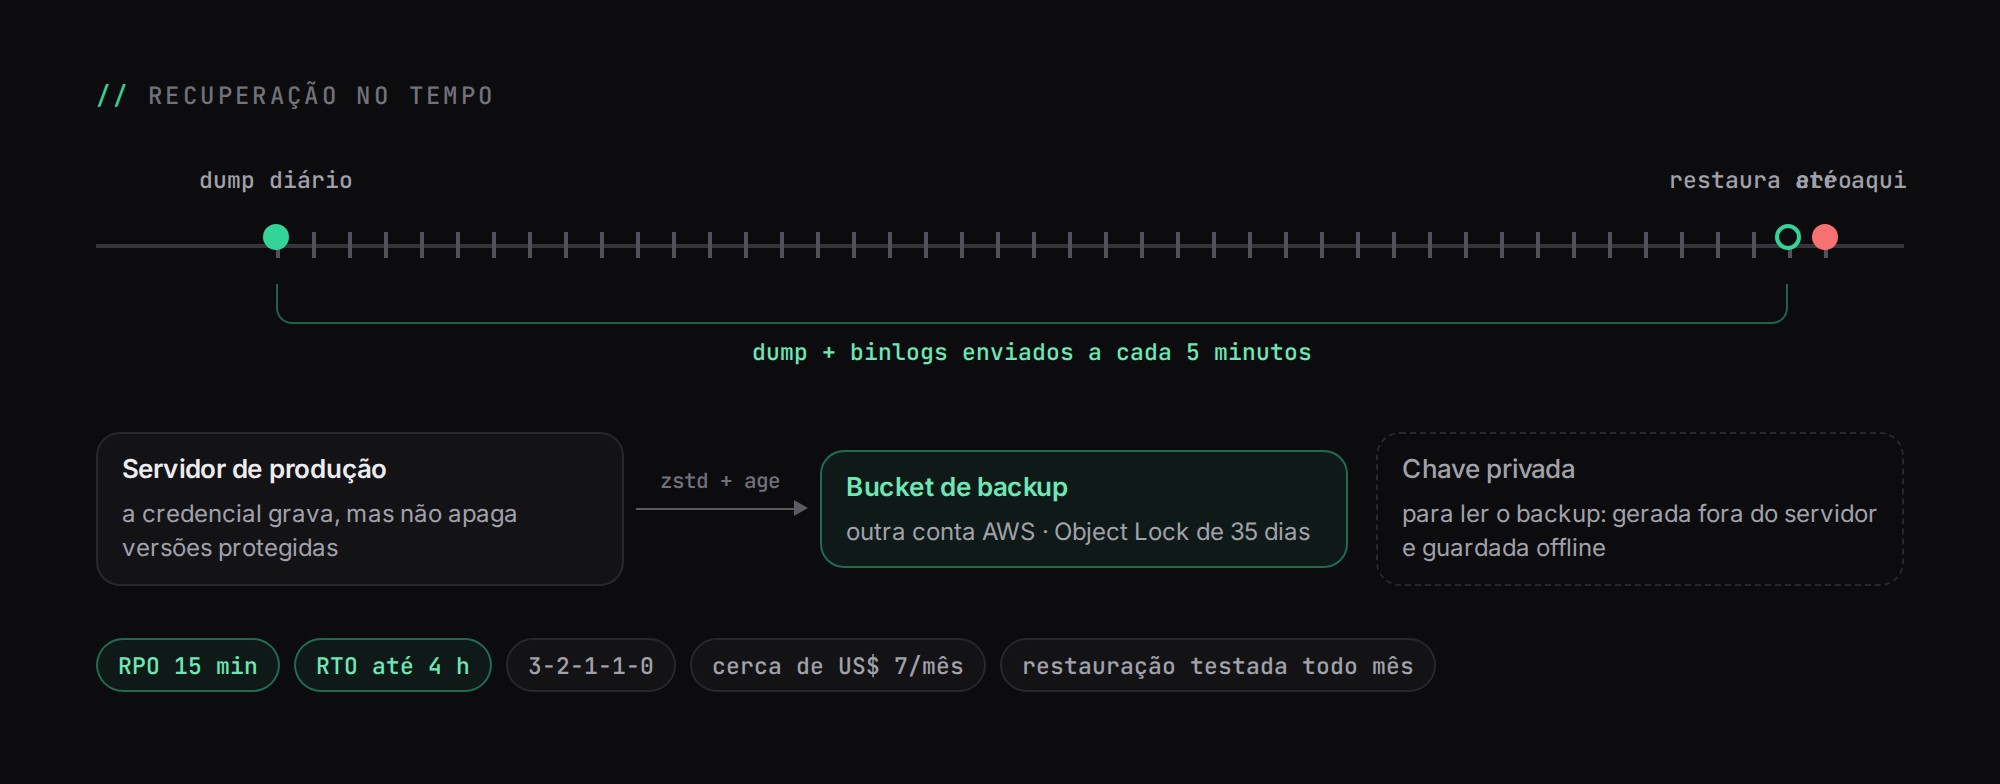
O plano parte de uma pergunta incômoda: o que eu perco se, agora, eu perder o acesso à conta do provedor do servidor? Com o backup diário do provedor, a resposta era "tudo", porque o backup morava na mesma conta. A régua que usei foi a regra 3-2-1-1-0: três cópias, em duas mídias, uma fora do provedor, uma imutável e zero erros no teste de restauração.
Contas separadas
Existe uma conta AWS só para backup, com outro e-mail, outra senha e MFA, fora da organização da produção. A credencial que o servidor usa para enviar backups consegue gravar, mas não consegue apagar versões protegidas. A premissa é que uma invasão do servidor expõe tudo o que está no ambiente dele, então nada no servidor pode destruir o backup.
Banco: dump diário e binlog a cada 5 minutos
Uma vez por dia sai um dump consistente do MySQL, comprimido com zstd e cifrado com age usando uma chave pública. A chave privada nunca esteve no servidor: foi gerada fora dele e fica guardada offline. A cada cinco minutos, os binlogs fechados são enviados para o mesmo bucket, que tem Object Lock com retenção de 35 dias.
Com o dump do início do dia e os binlogs seguintes, eu consigo restaurar o banco até um minuto antes de um erro, como uma migration que apagou o que não devia. Isso leva o RPO de "até 24 horas" para 15 minutos, e a meta de RTO para até 4 horas.
# esboço do pipeline do dump (simplificado)
mysqldump --single-transaction --source-data=2 ... \
  | zstd -3 \
  | age -r "$CHAVE_PUBLICA" \
  | aws s3 cp - "s3://$BUCKET_BACKUP/mysql/dump/$STAMP.sql.zst.age"
Arquivos: versões e réplica entre contas
Os buckets clínico e público têm versionamento ligado, com expiração de versões antigas depois de 90 dias. Um DELETE comum só cria uma marca de exclusão. Eles também replicam para a conta de backup, com uma configuração que importa muito: a replicação de marcas de exclusão está desligada. Se algo apagar arquivos na produção, a réplica continua intacta.
Chaves
Desde a criptografia do prontuário, um dump do banco sozinho não recupera texto clínico: as chaves de cada clínica são cifradas por uma chave mestra no AWS KMS. Se a conta de produção sumir, a chave mestra some junto. Por isso ela foi criada multirregião, com exclusão protegida por política e alerta, e existe uma cópia de recuperação das chaves de dados de cada clínica, cifrada com uma chave pública cuja privada também fica offline.
Vigilância que não depende do que falhou
O Sentry vê exceções que a aplicação consegue enviar. Um servidor desligado não envia nada, então a vigilância tem camadas:
- Uma rota de saúde que verifica banco, Redis, Horizon e o batimento do scheduler, monitorada de fora. Ela é separada da rota que o Docker usa como healthcheck, para que uma queda do banco não faça o Docker reiniciar a aplicação sem motivo.
- Heartbeats nas tarefas agendadas críticas (cobrança, pagamentos, recorrências financeiras), com
pingOnSuccessepingOnFailuredo scheduler do Laravel, e nos scripts de backup. A falta de sinal gera alerta. - Um auditor externo, num workflow agendado do GitHub Actions, que lista o bucket de backup e confere a idade e o tamanho do último dump e a sequência dos binlogs. A credencial dele só lista nomes, datas e tamanhos; nenhum dado de paciente passa pelo GitHub.
Backup só conta depois de restaurado
Todo mês, um servidor temporário recebe o dump mais recente e os binlogs até um horário escolhido, e eu confiro contagens de pacientes, agendamentos e registros clínicos e abro uma amostra de registro cifrado. A cada trimestre, um exercício completo recria o ambiente inteiro do zero, e o tempo medido é o RTO real, não o estimado.
Os procedimentos de recuperação estão escritos em seis roteiros, de R1 (recriar o servidor) a R6 (recuperar a chave mestra ou a conta AWS), passando por recuperação no tempo, rollback de deploy, restauração de arquivo e problemas de Redis ou disco. Um detalhe que aprendi escrevendo o R1: um banco restaurado volta o relógio dos dados. Se a aplicação subir normalmente, o scheduler encontra lembretes "pendentes" e cobranças "não processadas" e manda tudo de novo para pacientes reais. Por isso o roteiro sobe a aplicação em modo de manutenção, no qual o scheduler e o Horizon não executam, revisa o que não pode se repetir e só então libera.
Custo e próximos degraus
Tudo isso adicionou cerca de US$ 7 por mês à conta. Existem degraus seguintes, e eu os deixei escritos com o gatilho que justifica cada um:
- B: um standby do banco em outra região, para RTO de até 1 hora;
- C: banco e aplicação em servidores separados, com standby, quando carga e receita pedirem;
- D: um banco gerenciado Multi-AZ, se operar o MySQL deixar de fazer sentido.
Nenhum deles substitui o backup: uma réplica copia um DROP TABLE em segundos.
A infraestrutura é a parte menos visível do Markmedi. As outras partes da série tratam das filas, da criptografia do prontuário e do PWA.